note
Où est Zoé ? Gérer les accents et les signes diacritiques dans les Fabric Data Agents
Pourquoi un Fabric Data Agent peut ne pas trouver Zoé en recherchant zoe, comment les collations SQL insensibles aux accents peuvent aider et quand une colonne normalisée est plus performante.
Parfois, l’IA ne se trompe pas : elle est simplement trop littérale. Vous recherchez zoe alors que votre table contient Zoé. Votre Data Agent répond avec assurance : Aucun résultat trouvé. Zoé n’a pas disparu, elle se cache simplement derrière un accent !
Voyons pourquoi cela se produit — et comment corriger correctement le problème dans Microsoft Fabric.
Quelques mots sur les signes diacritiques — et pourquoi ils comptent
Prenons une simple table employee, avec un identifiant, un département, un prénom et un nom. L’entreprise est française ; les noms comportent donc un certain nombre d’accents.
id,prenom,nom,departement
1,Jean,Dupont,IT
2,Élodie,Martin,HR
3,François,Lambert,Finance
4,Marie,Curie,IT
5,André,Bernard,Marketing
6,Cécile,Durand,Finance
7,Pierre,Moreau,IT
8,Naïma,Legrand,HR
9,Luc,Petit,Marketing
10,Ève,Robert,IT
11,Paul,Dubois,Finance
12,Zoé,Merci,HR
13,Antoine,Girard,Marketing
14,Ça va,Test,Légal
15,Loïc,Deschamps,IT
16,Inès,Fournier,Finance
17,Thomas,Rousseau,HR
18,Audrey,Tremblay,Marketing
19,Étienne,Perrot,IT
20,Camille,Lefèvre,Finance
Une fois ces données chargées dans une table Lakehouse et notre Data Agent configuré, essayons de trouver Zoé.
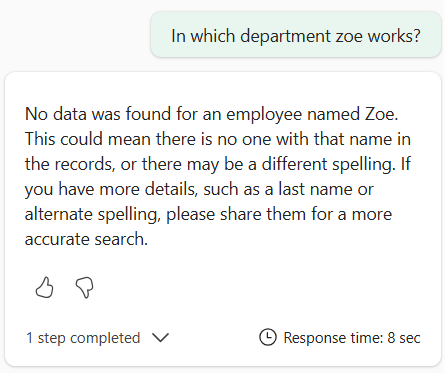
Si vous avez lu le titre de cet article, vous vous attendiez probablement à ce résultat 🙂. Avant de nous plonger dans le SQL, précisons ce dont nous parlons. Un signe diacritique est un signe ajouté à une lettre qui en modifie la prononciation ou le sens. Par exemple, dans les langues utilisant l’alphabet latin :
- é, è, ê (français)
- ñ (espagnol)
- ü (allemand)
- ç (français, portugais)
Dans de nombreux pays, supprimer l’accent ne change pas l’identité dans l’usage courant. « Zoé » et « Zoe » désignent la même personne. Mais techniquement, il s’agit de caractères Unicode différents.
Regardons maintenant la requête SQL générée par le Data Agent.
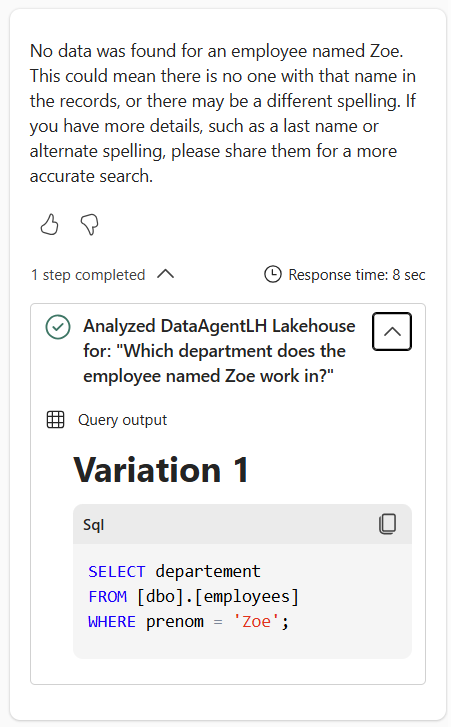
Le LLM qui alimente le Data Agent a en pratique transcrit notre requête en langage naturel dans le dialecte SQL. Nous obtenons donc le prédicat WHERE prenom = 'zoe'. Or, les règles par défaut de tri et de comparaison des données textuelles dans le point de terminaison SQL du Lakehouse — ce que l’on appelle une collation — sont sensibles aux accents (et, pour être précis, il s’agit de Latin1_General_100_BIN2_UTF8).
Ainsi, zoe est différent de Zoé.
Comment rendre le Data Agent plus intelligent face aux accents ?
À l’heure où j’écris ces lignes, il n’est pas possible de remplacer la collation d’un point de terminaison SQL par une collation qui effectue des comparaisons insensibles aux accents. Vous devez le faire au niveau de la requête :
SELECT id, prenom, nom, departement
FROM employees
WHERE prenom COLLATE Latin1_General_CI_AI LIKE '%zoe%'
Cette requête renverra Zoé, même si le terme recherché est zoe. Vous pouvez demander au Data Agent d’utiliser cette construction au moyen d’instructions propres à la source de données.
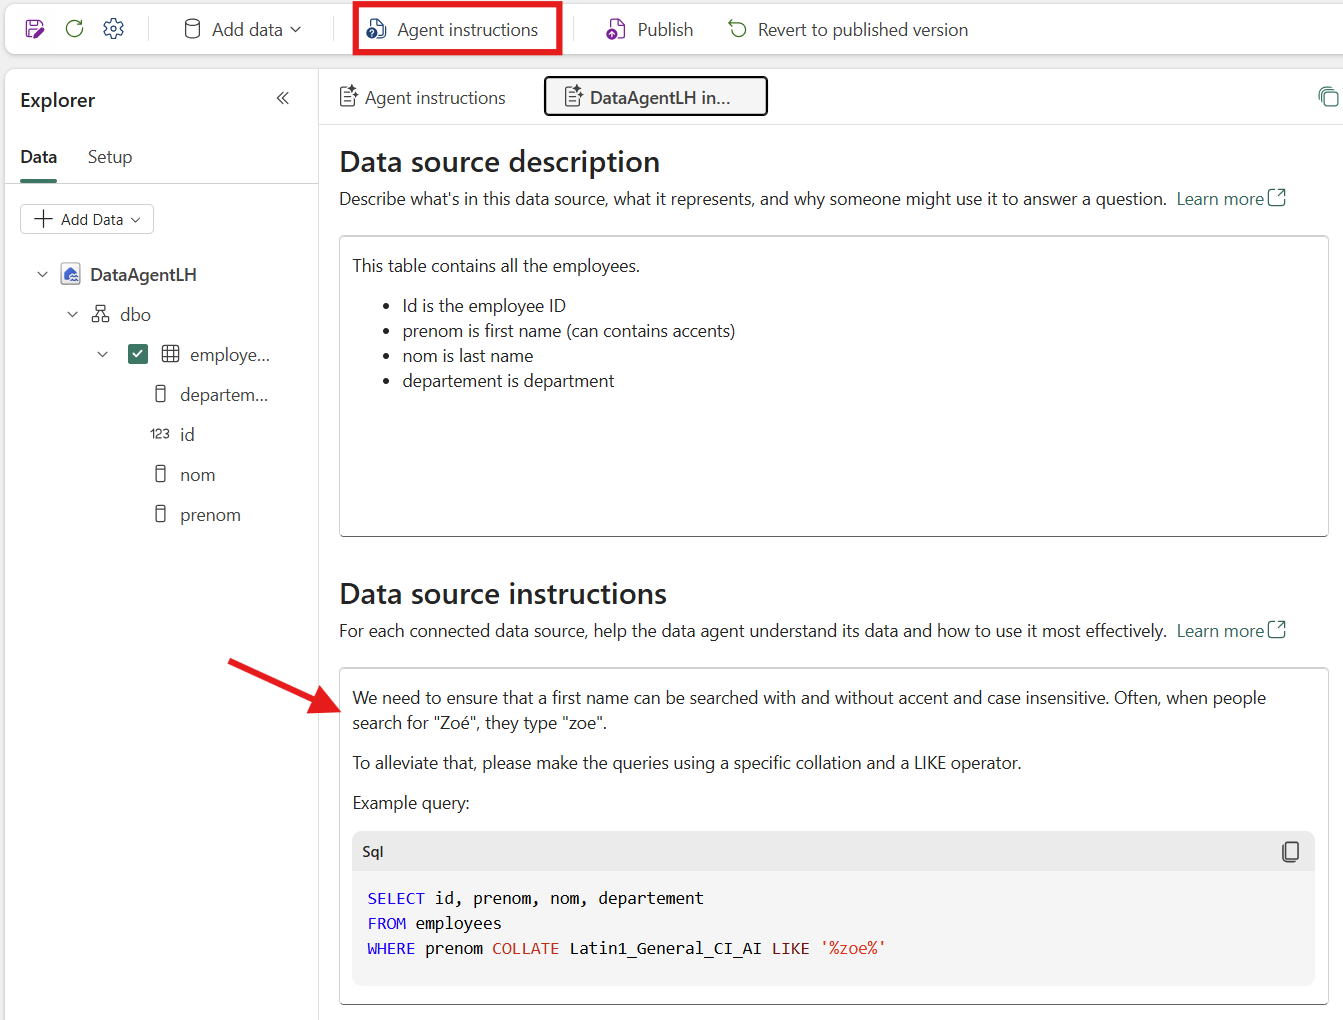
Une fois les instructions personnalisées ajoutées, posons à nouveau notre question.
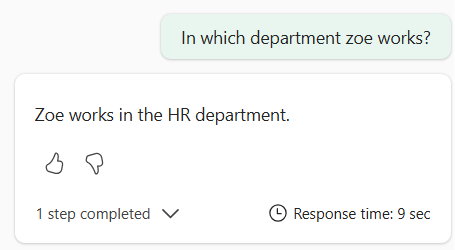
Nous avons trouvé Zoé !
Un avertissement sur les performances
Je n’ai pas étudié les détails de l’implémentation interne, mais nous savons avec certitude que le format de fichier Delta ne comprend pas les collations propres à SQL. Le stockage physique des données n’est donc pas organisé de façon à les interroger efficacement avec la bonne méthode de comparaison des lettres. Le moteur SQL devra probablement parcourir l’ensemble du jeu de données pour effectuer ce filtrage.
S’il s’agit d’une requête ponctuelle et que vous avez quelques milliers d’enregistrements, la solution ci-dessus devrait convenir. Si vous exécutez souvent cette requête ou si vous avez des millions d’enregistrements, mieux vaut calculer une nouvelle colonne contenant une valeur normalisée.